DoLQ:融合定性定量评估的ODE发现方法
论文信息
| 字段 | 内容 |
|---|---|
| 标题 | Discovering Ordinary Differential Equations with LLM-Based Qualitative and Quantitative Evaluation |
| 作者 | Sum Kyun Song, Bong Gyun Shin, Jae Yong Lee |
| 机构 | 韩国中央大学人工智能系、大陈大学 |
| 论文地址 | https://arxiv.org/abs/2605.07323 |
| 代码地址 | https://github.com/Bon99yun/DoLQ |
| 发表时间 | 2026年5月(ICML 2026) |
一句话概要
现有符号回归方法依赖定量评估(如MSE)来发现微分方程,但数值误差相近的方程可能对应截然不同的物理机制。为解决此问题,论文提出DoLQ框架,引入LLM驱动的多智能体协作:采样智能体基于物理描述提出候选项,科学家智能体对候选方程同时进行定性语义评估与定量消融测试,综合二者结果指导搜索。在八个基准ODE系统上,DoLQ在NMSE测试中成功解决7个问题(Term测试5个),显著优于LLM-SR(4个和2个),同时token消耗更少。消融实验表明,科学家智能体将收敛从第62轮加速至第27轮。
背景与研究动机
从观测数据中发现支配性微分方程是科学机器学习中的核心挑战。论文指出,微分方程是描述物理、化学、生物等领域系统动态行为的基本工具,但当方程形式未知时,必须从观测数据中推断。相关领域的两条主线是:SINDy方法通过预定义基函数库和稀疏回归来识别动力学,但难以应对函数形式未知的系统;符号回归(SR)方法通过搜索符号函数来逼近观测数据,突破了库约束的限制。然而,这两类方法在评估候选方程时,主要依赖定量指标(如MSE或模型复杂度),而图1中展示的一个关键反例构成了论文的核心动机:两个不同的微分方程可以产生与其真实方程同样低的MSE,这意味着仅靠数值误差无法保证发现正确的物理机制。
可以理解为,这一反例揭示了一个根本性困境——数值拟合精度与物理正确性并不等价。由于科学中的微分方程往往基于自然现象和人类直觉,发现项(terms)的物理合理性变得至关重要。引入能够理解物理语义的定性评估,是弥合这一差距的必然方向。
现有方法的瓶颈
现有符号回归方法主要面临三个层面相互关联的局限,这些问题在复杂动力系统中尤为突出。
第一,评估标准单一致使物理正确性无法保障。 论文明确指出,现有方法主要依赖定量指标(如MSE或模型复杂度),而图1的例子说明,数值误差相近的方程可能对应不同的物理机制。这意味着仅靠数值拟合无法区分偶然符合与真实因果,科学发现中关键的物理一致性被忽略了。
第二,复杂函数形式的搜索能力有限。 对于包含多项式、有理函数、三角函数和指数项的系统,传统方法表现出明显不足。分析来看,这一局限的根源在于两种主流方法各自的短板:SINDy受限于预定义基函数库的覆盖范围;进化算法(如LASR)虽然可以生成多种函数形式,但其搜索能力在复杂组合空间中急剧下降——论文实验显示,LASR在涉及非多项式形式的系统上基本失败。
第三,现有LLM辅助方法存在过度生成问题。 论文指出,LLM-SR等基于LLM的符号回归方法虽然利用了大语言模型的先验知识,但其候选方程包含大量不必要的项,这不仅使参数优化复杂化,还生成了不必要的冗长提示。分析来看,这种过度生成源于LLM生成能力的开放性与科学简洁性要求之间的张力——LLM倾向于"多提一些试试",而缺乏对候选项的有效筛选机制。图5中的token消耗数据印证了这一判断:LLM-SR消耗的token远超DoLQ,在4D滑翔机系统上,LLM-SR的输出token达到1379K,而DoLQ仅为264K。
值得注意的是,这三层局限是嵌套的:评估标准单一使得系统无法过滤不合理的项,过度生成加剧了搜索空间的膨胀,而有限的搜索能力在面对复杂函数形式时更是捉襟见肘。这些瓶颈共同指向一个核心需求——引入能够理解物理语义的评估机制,在搜索过程中早期识别并剔除物理上不合理的候选。
核心洞察与贡献
论文的核心洞察可以概括为:定性语义评估与定量消融测试的结合,能够产生比纯数值评估更优的搜索引导信号。 具体而言,科学家智能体对每个候选项同时评估两件事——该项是否有物理意义(定性的),以及去除该项后误差是否显著变化(定量的)。综合这两类信号,可以高效地识别出哪些项真正需要保留,哪些是冗余或有害的。这一洞察的深层逻辑在于,物理合理性是更严格的前置条件:一个项如果物理上没有意义,即使暂时提升了数值拟合,也往往是虚假相关(spurious correlation),应该被排除。
- 集成定性-定量评估框架:DoLQ将物理推理显式嵌入搜索循环,引导发现过程朝向同时满足数值精度和物理可解释性的方程,同时保持紧凑的结构。
- 在复杂系统上达到最优性能:在八个基准ODE系统上,DoLQ在NMSE测试和Term测试中均获得最高成功率(7/8和5/8),尤其擅长现有方法难以处理的复杂函数形式。
- 定性评估的有效性验证:通过消融实验证明,定性评估在过滤物理上不合理的项方面发挥了关键作用,将收敛速度提升一倍以上(第27轮对比第62轮)。
方法详解
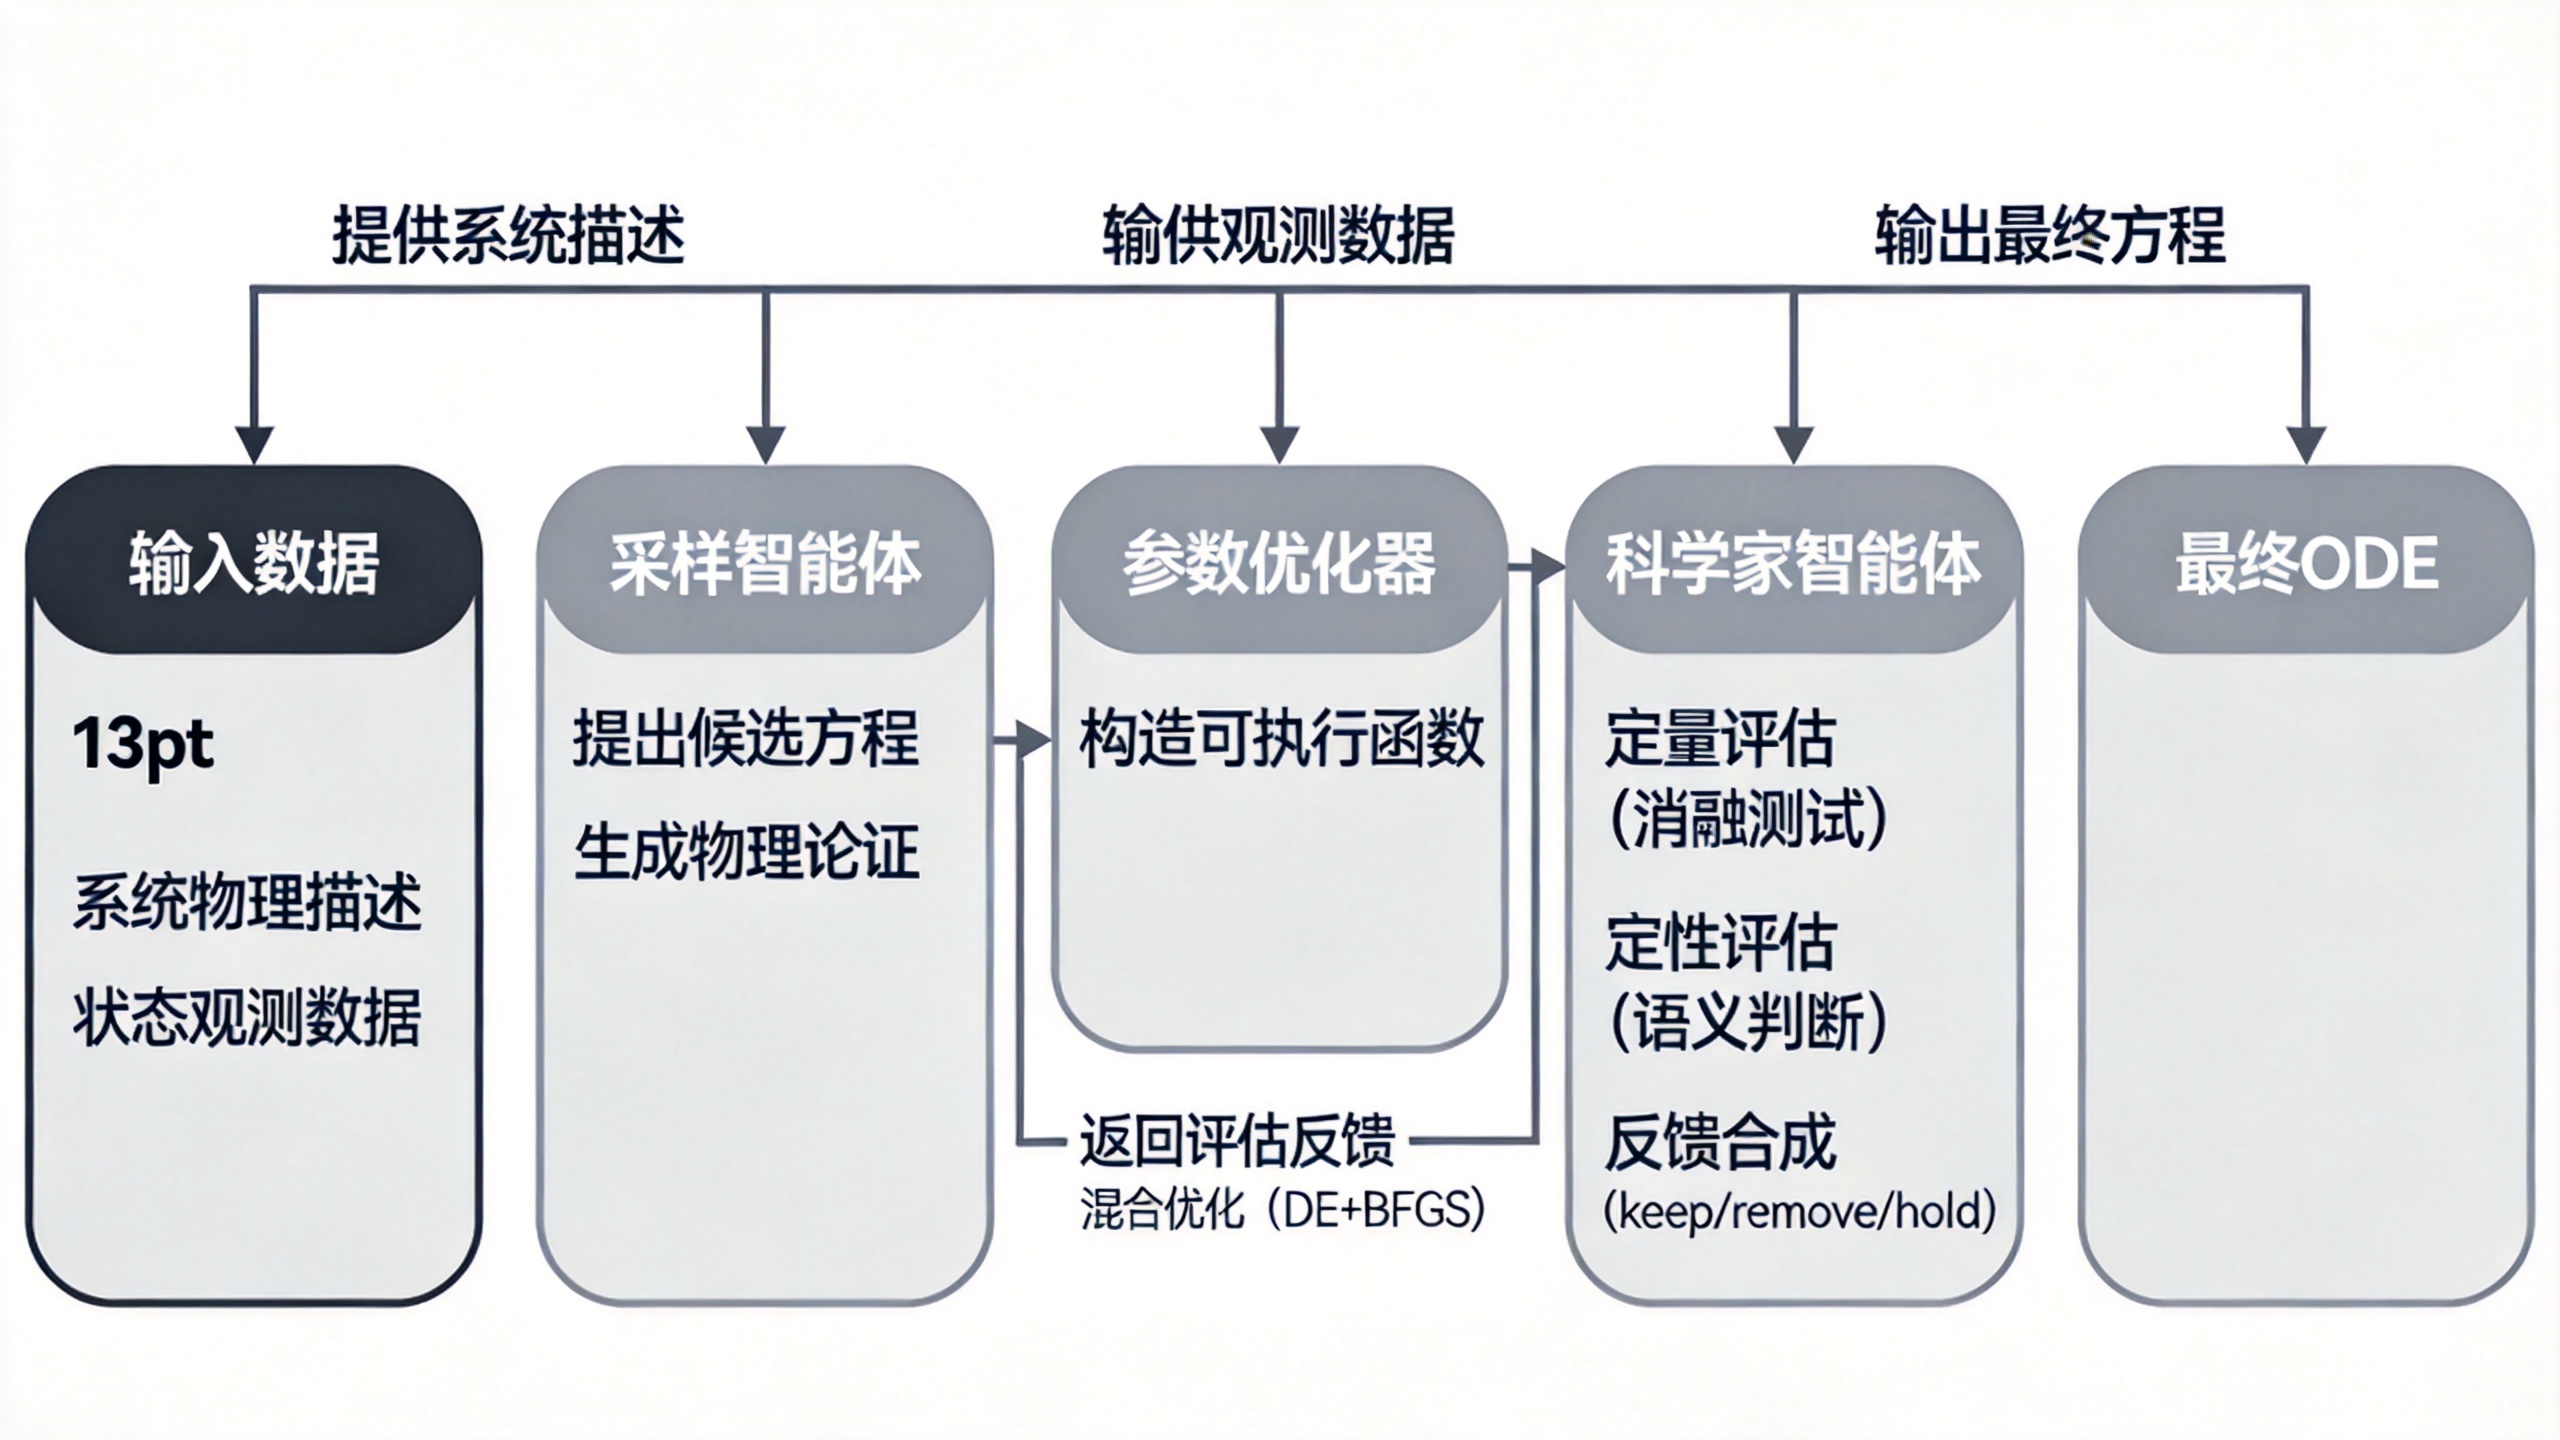
DoLQ是一个由三个智能体组成的迭代协作框架,分别负责候选生成、参数优化和综合分析。每个智能体承担明确角色,形成完整的发现回路。
采样智能体
采样智能体是一个基于LLM的组件,提出各状态维度的候选项以及基于系统描述的物理论证。其输入包含三部分:任务角色说明和系统描述(提供物理背景信息)、科学家智能体的历史反馈(包括积累的知识、逐项评估结果和已移除项列表)、技术约束(输出格式要求和示例)。
采样智能体输出的候选方程采用结构化格式,每个符号项附带自然语言论证。关键设计是,每个项被格式化为可执行的Python代码片段,利用状态变量和参数占位符(如 params[0]*x),这使得参数优化步骤可以直接处理LLM的输出。值得注意的是,论文明确要求系统描述中不能包含具体的数学公式结构(如禁止出现 -cx² 或 sin(x)),确保模型必须依赖物理直觉而非记忆符号形式。
参数优化器
参数优化器将候选项列表转化为精确的微分方程,包括两个步骤:构造可执行函数和混合参数优化。
构造可执行函数:对于每个项集合,构建一个可执行的骨架函数,其中符号项实例化为具有可训练参数的形式。
混合优化策略:优化的目标是最小化残差MSE:
其中 通过有限差分从观测数据数值估计。论文选择残差MSE而非积分MSE(公式1)有两个关键原因:积分MSE需要在每个优化步骤中进行昂贵的数值积分;在多维系统中,一个维度的误差会导致轨迹发散,即使其他维度识别正确也会获得差分数。残差MSE独立评估每个维度,实现了正确的贡献分配。
论文采用混合优化策略,先应用微分进化(differential evolution)识别有前景的参数区域,再用BFGS进行精调,最终在三者中(仅BFGS、仅微分进化、混合策略)选择MSE最低的候选。图8清晰展示了为什么这一设计是必要的:即使骨架结构完全正确,BFGS也可能因为初始化敏感性和局部极小值而失败,只有混合优化器成功恢复了解。论文还指出,微分进化成功找到最优参数验证了LLM提出的骨架与真实解结构相似——如果单纯依赖BFGS失败,就会错误地拒绝一个合理骨架,掩盖提出结构的真实质量。
科学家智能体
科学家智能体是DoLQ的核心差异化组件,它从定性和定量两个互补视角评估每个候选项,综合结果后向采样智能体提供反馈。
定量评估采用消融测试:对每个项暂时将其系数设为零,重新计算残差MSE。如果去除某项后误差显著增加,则该项具有正面贡献(good);如果误差不变或减小,则是中性(neutral)或负面(bad)。这一设计的动机是识别哪些项真正贡献了数值拟合,与定性评估形成互补。
定性评估则由科学家LLM判断每个项与系统描述中物理含义的匹配程度,语义质量被分为good、neutral、bad三个等级。论文明确提出,对定性评估不设定严格的评分标准,而是由LLM基于系统描述作出判断——这既是灵活性的体现,也构成了方法的一个潜在局限。
反馈合成的决策逻辑是:语义质量为bad的项直接移除;语义和定量均为good的项标记为keep;其他所有组合标记为hold。连续两次hold的项升级为remove。已移除的项骨架被记录以防止重复提出,但设置概率性遗忘机制(遗忘概率0.01)定期清除这些记录,允许重新探索之前被拒绝的候选。这一设计体现了探索与利用的平衡:严格过滤不合理项的同时,保留容错空间。
可以理解为,整个决策矩阵(表10)的设计体现了一种"安全优先"的哲学:定性评估具有一票否决权,而定量评估只有在定性过审后才发挥作用。这种不对称设计防止了数值偶然性主导物理发现。
实验与结果
基准与实验设置
论文使用ODEbench中的七个ODE问题及一个自构建的4D滑翔机系统,共八个基准。实验在两个评估域上进行:域内(ID)用于训练和选择,扩展域内(ID-Ext)通过延长时间或状态空间覆盖范围来评估泛化能力。扩展域内评估的设计动机是,传统的域外(OOD)评估需要新的初始条件,而在积分MSE验证场景中未必可用,因此采用扩展域内作为替代方案。
基线方法包括ICSR、LASR、LLM-SR和EDL,均使用Gemini 2.5 Flash Lite作为底层LLM。搜索预算方面,DoLQ执行100次迭代,基线方法按维度进行相应配置。这一设计是否公平值得讨论:DoLQ的100次迭代是系统级(所有维度联合),而基线方法按维度执行,实质上对所有方法给予了可比的计算资源。
定量性能对比
表2展示了在三个代表性系统(SIR、CDIMA、Glider(4D))上的定量结果。在SIR(2D)系统上,大多数方法都达到了低误差,因为方程形式相对简单。论文指出,许多模型几乎从第一次迭代就找到了正确结构,说明现有方法在问题结构简单时是有效的。
CDIMA(2D)系统呈现出根本性挑战。论文明确指出,显著差异出现在残差NMSE和积分NMSE之间:基线模型通常具有低残差NMSE但高积分NMSE,这表明它们未能捕捉真实物理动力学,而是通过过拟合导数匹配获得了表面上的低误差。只有DoLQ在所有评估指标上保持一致的优异表现,积分NMSE达到 (ID)和 (ID-Ext),远优于次优的LLM-SR(分别为0.0049和0.0072)。
分析来看,CDIMA系统的非线性饱和项(包含有理函数 )构成了分水岭:过拟合数值导数比学习真实动力学更容易获得低残差NMSE,但积分NMSE暴露了模型对长期动态的误解。DoLQ的优势正在于定性评估阻止了这类虚假拟合。
结构对比
图3展示了2D无量纲滑翔机系统上的方程结构对比。论文将结果分为两组:合理NMSE组(DoLQ和LLM-SR)和较高NMSE组(其他基线)。DoLQ成功识别了所有实真项,而LLM-SR虽然也识别了实真项,但提出了大量不必要的项。论文指出,DoLQ的高效性源于科学家智能体的严格评估:有益项获得正面评价,有害项明确识别和移除,防止其在后续迭代中重现。
值得注意的是,论文在此处使用的"结构对比"方法本身具有一定局限性:它依赖于人工分类和视觉比较,而非自动化的符号匹配指标。论文在附录C.3中提出了Term测试(结构匹配度),但这一评估的严格程度受限于对可忽略项的裁剪阈值设置。
成功率的总体对比
图4显示了八个基准上的成功得分,DoLQ在NMSE测试(7/8)和Term测试(5/8)中均达最高。与此对比,LLM-SR在NMSE测试中成功4个,但Term测试中仅成功2个。这一差异揭示了关键问题:LLM-SR能够找到数值拟合良好的方程,但其结构常常与实真方程不一致,因为大量冗余项的加入虽然参与了拟合,却掩盖了真正起作用的物理机制。
消融实验与组件验证
科学家智能体的必要性(图6):将DoLQ与去掉科学家智能体的变体(w/o Scientist)对比,发现完整DoLQ在第27轮发现正确方程,而去除后需要第62轮。论文进一步通过推理日志分析确认,科学家智能体的反馈有效过滤了物理上不合理的项,加速了搜索过程。但需注意,图6展示的是最佳运行轨迹而非多次运行的平均结果——论文明确表示所有方法运行三次并报告最佳结果,这意味着收敛速度的差异可能部分归因于随机性。
混合优化策略的有效性(图8):实验证明,即使正确的方程骨架,仅用BFGS也可能因为初始化不当而失败,而混合优化器成功恢复了解。附录D进一步分析了优化器选择频率随问题复杂性的变化:在简单系统上BFGS更常用,在复杂系统上微分进化更常被选用。值得注意的是,图11还揭示了一个更微妙的优势:当使用实真骨架结构时,微分进化获得了更低MSE,为正确骨架分配了更优分数,这反过来促进了更有效的搜索。
决策模式分析(图7):对Glider(2D)过程中各项目的动作频率分析显示,实真项持续获得高keep频率,证明科学家智能体有效识别了物理相关项。即使这些项偶尔被remove,它们也通过概率采样机制频繁重现,实现了鲁棒的收敛。
批判性评估
Baseline选择的覆盖范围:论文选择的四种基线涵盖了LLM辅助SR的主要方向(进化搜索、自改进、上下文学习、概念库),并均适配到ODE发现场景。但缺少与ODE-specific方法(如ODEformer)的直接对比——虽然论文在相关工作部分提及了ODEformer,但未将其纳入定量比较。这可能是因为ODEformer不直接利用文本描述,但对比结果仍具有参考价值。
消融实验的完整性:论文证明了科学家智能体(定性评估)的必要性,但对混合优化策略中两个组件(微分进化和BFGS)各自的贡献缺乏系统消融。虽然附录D分析了优化器选择频率,但这并非控制实验——更严谨的设计应当是固定骨架后比较三种优化策略的成功率。此外,概率遗忘机制(遗忘概率0.01)的敏感性未作探讨。
实验结论对核心主张的支撑度:论文的核心主张是定性评估能提升发现效果。NMSE和Term测试的总体结果确实支持这一主张。然而,需要指出的是:定性评估完全依赖LLM的语义理解能力,论文中的实验均使用Gemini 2.5 Flash Lite,未验证其他LLM的鲁棒性。附录F提供了GPT-4o mini、DeepSeek-V3.2和Grok 4.1 Fast的补充结果,其中GPT-4o mini表现出明显降级,这暗示方法对底层LLM的选择敏感。
噪声鲁棒性:附录G.1的噪声鲁棒性实验是一个重要但被放在附录中的局限分析。结果表明,DoLQ在噪声下性能显著下降(σ=0.1时平均NMSE达到32.58),甚至不如部分基线。论文诚实承认"DoLQ does not intrinsically filter observation noise",这限制了方法在真实(含噪)科学数据上的适用性。
优势与局限性
优势
- 定性定量融合的最优设计:科学家智能体的双评估机制产生了协同效应,定性评估过滤不合理项,定量评估识别有效项,两者互为补充。实验结果充分证明了这一设计的有效性。
- 结构紧凑性:相比LLM-SR的冗余生成,DoLQ发现的方程显著更简洁,这直接受益于科学家智能体的严格筛选机制。
- 搜索效率:在多种指标(收敛速度、token消耗、内存占用)上均优于或持平于强基线。表23显示,在4D滑翔机系统上,DoLQ的峰值内存仅为0.238 GiB,远低于LLM-SR的0.422 GiB。
局限性
- 噪声敏感性:论文坦诚指出参数优化依赖数值微分,对测量噪声敏感。附录G.1的定量结果确认了这一局限——方法在含噪场景中的性能下降显著。
- 推理固化倾向:论文在附录H.1的幻觉审计中揭示了一种称为"premature mechanistic storytelling"的模式:LLM在数值证据充分积累之前就为探索性的项赋予了自信的物理叙事。虽然这些项最终未进入最终方程,但它们影响了搜索方向。
- 对错误描述的脆弱性:附录G.2的实验表明,当提供部分不匹配或完全错误的自然语言描述时,DoLQ的发现性能显著下降(平均残差NMSE从 量级退化到 量级),且无法自动修正错误先验知识。这意味着方法对文本描述的质量高度敏感。
- 可复现性方面:代码已开源,超参数和温度设置明确(表5),但依赖商业LLM(Gemini 2.5 Flash Lite),完全复现受限于API可用性和版本漂移。论文未提供多次运行的统计波动分析(只报告了最佳运行),对性能的稳定性评估不足。
未来方向与开放问题
- 积分形式的参数估计:论文指出当前使用残差MSE(导数匹配)而非积分MSE(轨迹匹配),后者虽更可靠但计算代价高。开发高效的积分式参数估计方法是直接的前进方向。
- 针对噪声的鲁棒性增强:噪声敏感性是方法部署于真实科学数据的核心障碍。如何将去噪机制或概率建模融入框架,是需要解决的关键问题。
- 扩展到偏微分方程:论文坦言由于缺乏通用求解器,扩展到PDE面临重大困难。这是一个开放且极具价值的方向,需要结合PDE求解器研究的最新进展。
- 多样化假设生成与细化反馈:论文自身指出推理固化(premature convergence)问题。如何通过更精细的反馈机制或强制多样性搜索来缓解,是值得探索的方向。
- 跨域迁移能力:方法目前仅评估于物理/化学/生物系统。其有效性是否依赖底层LLM在该领域的预训练知识?在更冷门或交叉领域中的表现需要进一步验证。
组会预判问答
Q1: 定性评估是否过于依赖LLM的领域知识?如果系统描述不完备或包含错误怎么办? 论文附录G.2的实验直接表明,DoLQ对错误描述敏感——在部分不匹配和完全不匹配描述下,发现性能显著下降。论文确认方法"inherently trusts the provided qualitative description and lacks an intrinsic mechanism to correct erroneous prior information"。这意味着在实际应用中,系统描述的质量至关重要,甚至可能决定发现的成败。
Q2: 为什么在CDIMA系统上基线方法的残差NMSE和积分NMSE差异如此之大? 论文明确指出这是因为"过拟合"现象:基线模型通过拟合导数匹配实现了低残差误差,但未能捕捉真实动力学,导致轨迹积分后误差急剧扩大。这实际上揭示了仅用导数匹配评估的潜在隐患,也正是DoLQ引入定性评估的核心动机之一。分析来看,CDIMA包含非线性饱和项 ,这类有理函数通过幂级数展开可以近似,但近似解的长期行为与原系统有本质差异。
Q3: DoLQ的Term测试标准是否过于宽松?忽略可忽略项的阈值如何设定? 论文在Term测试中采用"排除可忽略项后匹配真实结构"的标准,附录C.3指出了阈值的设定依赖实验配置。这是一个合理的设计选择——科学方程发现中,微小的冗余项(系数接近零)不应被视为失败。但这也意味着对"可忽略"的界定需要标准化,否则不同研究间的比较难以公平。
Q4: 为什么论文未与ODEformer等ODE-specific方法对比? 论文选择对比的是基于LLM的SR方法(LLM-SR、ICSR、LASR、EDL),原因是这些方法都能利用文本描述(这是DoLQ的核心组件)。ODEformer虽专用于ODE发现,但不利用文本输入,构建公平对比需要额外适配。论文在相关工作部分对其进行了概念定位,但实验对比的缺失确实是一个缺口。
Q5: 论文中"NMSE测试成功"和"Term测试成功"的标准具体是什么?二者关系如何? NMSE测试要求所有维度的积分NMSE < ,而Term测试要求发现方程与实真方程结构匹配(排除可忽略项后)。论文表13的详细得分显示,二者不完全重合:DoLQ在NMSE测试中成功7个,但Term测试中成功5个。这种差异意味着有些方程虽然数值精度达标,但结构并未完全恢复实真形式(可能存在形式等价的不同表达)。值得注意的是,NMSE测试具有更强的实际意义——如果方程在数值上等价,结构差异可能源于数学恒等式。
本报告由立理AI生成,仅供参考,请以原文为准。
