可解释人工智能综述:概念、分类与挑战
论文信息
| 字段 | 内容 |
|---|---|
| 标题 | Explainable Artificial Intelligence (XAI): Concepts, Taxonomies, Opportunities and Challenges toward Responsible AI |
| 作者 | Alejandro Barredo Arrieta, Natalia Díaz-Rodríguez, Javier Del Ser, Adrien Bennetot, Siham Tabik, Alberto Barbado, Salvador Garcia, Sergio Gil-Lopez, Daniel Molina, Richard Benjamins, Raja Chatila, Francisco Herrera |
| 机构 | TECNALIA, ENSTA, University of the Basque Country, BCAM, University of Granada, Telefonica 等 |
| 论文地址 | 发表于 Information Fusion, 2020 |
| 发表时间 | 2019年12月(预印本) |
一句话概要
论文围绕可解释人工智能(XAI)展开系统性综述,首先澄清了解释性与可理解性等核心概念,提出以"受众"为核心的XAI新定义;随后构建了涵盖透明模型与事后可解释性的双层分类体系,覆盖约400篇文献;重点剖析了深度学习模型的可解释性挑战与最新进展;最后将XAI置于负责任AI的框架下,探讨了XAI在公平性、隐私、数据融合等领域的交叉问题与开放挑战。
背景与研究动机
随着深度学习等黑箱模型在医疗、金融、司法等高风险决策场景中的广泛部署,模型的可解释性已成为AI实用化的关键瓶颈。论文指出,尽管现代AI系统在性能上取得了突破性进展,但人类对这些"智能"系统如何做出决策的理解却极为有限。这种"可理解性赤字"不仅阻碍了AI在受严格监管行业的落地,更可能引发信任危机与伦理风险。
作者强调,可解释性具有三重实用价值:确保决策的公正性(检测并纠正训练数据中的偏见)、增强模型的鲁棒性(识别可能改变预测的对抗扰动)、保证因果关系的真实性(只有有意义的变量参与输出推断)。这些价值共同指向一个核心诉求——AI系统的开发和应用需要从"纯性能导向"转向"负责任导向"。
值得注意的是,论文指出尽管对可解释AI的需求由来已久,但直到2017年前后,XAI才真正成为研究社区的热点,相关文献数量呈现爆发式增长。这一现象背后既有技术层面的推动(深度学习的广泛部署),也有政策法规的驱动(如GDPR中关于"解释权"的讨论)。
现有方法的瓶颈
论文对XAI领域现有研究的分析揭示了一系列系统性不足,这些不足可以概括为以下几个层面:
第一,核心概念混乱与定义不统一。 论文指出,学界长期以来混用"interpretability"(可解释性)与"explainability"(可解释性)等术语,这两者在语义上存在本质差异:可解释性(interpretability)是指模型本身被动具有的、对人类观察者而言易于理解的特征;而解释性(explainability)则是指模型主动采取行动或程序来阐明其内部功能。这种概念混淆严重阻碍了研究社区形成统一的交流基础与评价标准。
第二,忽视目标受众的差异化需求。 论文认为,现有的XAI研究大多默认存在一种"通用解释",但事实上,不同受众需要不同深度和形式的解释。医疗专家可能关注因果机制,监管机构需要合规性验证,终端用户则在意公平性。论文形象地指出了这一缺口——一个解释是否"清楚"或"易于理解",完全取决于受众。
第三,缺乏统一的概念框架与分类体系。 尽管已有多个综述尝试分类XAI方法,但论文认为这些分类要么不完整,要么未能有效覆盖不同模型(尤其是深度学习)的特异性。领域需要一份统摄性的分类学来组织知识、引导研究。
第四,评估指标缺失导致研究难以量化比较。 如何衡量一个解释的"好"与"坏"?论文指出,虽然有少量工作尝试提出XAI评估方法(如满意度调查、心智模型测量等),但领域仍缺乏通用的、可量化的XAI指标。这使得不同方法之间无法进行公平的比较,也阻碍了领域从定性描述走向定量评估。
第五,XAI与数据融合、隐私保护等交叉领域研究空白。 论文特别指出,在数据融合场景下,XAI的应用既可能增强模型理解,也可能泄露敏感信息——这一悖论几乎未被研究。
核心洞察与贡献
这篇综述的核心洞察在于:XAI不仅是一个技术问题,更是一个涉及受众、目的与社会伦理的系统性问题。 作者从根本上将"解释"重新定义为一种接口——连接人类与决策者的接口,其有效性取决于对受众认知特征的精准把握。这一洞察将XAI从单纯的技术工具提升为人机交互与社会治理的综合议题。
基于此洞察,论文的贡献可归纳如下:
-
提出以受众为中心的XAI新定义。 论文明确定义:给定特定受众,可解释AI是指能够提供细节或理由以使其功能清晰或易于理解的AI。这一定义将受众的认知能力与目标纳入解释的核心考量,弥补了Gunning定义中忽略目的多样性的不足。
-
构建了两层分类体系。 论文提出了一个涵盖约400篇文献的分类框架:第一层按"透明性"与"事后可解释性"区分模型,第二层聚焦深度学习模型,按解释对象(处理过程 vs. 内部表征)和解释方式(简化、局部解释、可视化等)进一步细分。
-
系统梳理了六种XAI目标。 论文从文献中提炼出信任度、因果性、可迁移性、信息性、置信度、公平性、可及性、交互性和隐私意识九种解释目标,并建立了其与目标受众的对应关系。
-
将XAI定位于负责任AI的枢纽位置。 论文将XAI嵌入包含公平性、问责制、隐私和透明度的负责任AI框架中,明确XAI不是独立目标,而是实现负责任的AI部署的关键支撑。
-
开辟了XAI与数据融合、隐私安全的交叉研究议程。 论文系统探讨了数据级、模型级和知识级融合中XAI的机遇与风险,揭示了XAI在贡献隐私保护与构成隐私威胁之间的两面性,这一分析在此前的文献中罕见。
核心框架
论文的整体框架围绕"概念—分类—挑战—负责任AI"的逻辑链展开,核心可以解构为以下四大模块。
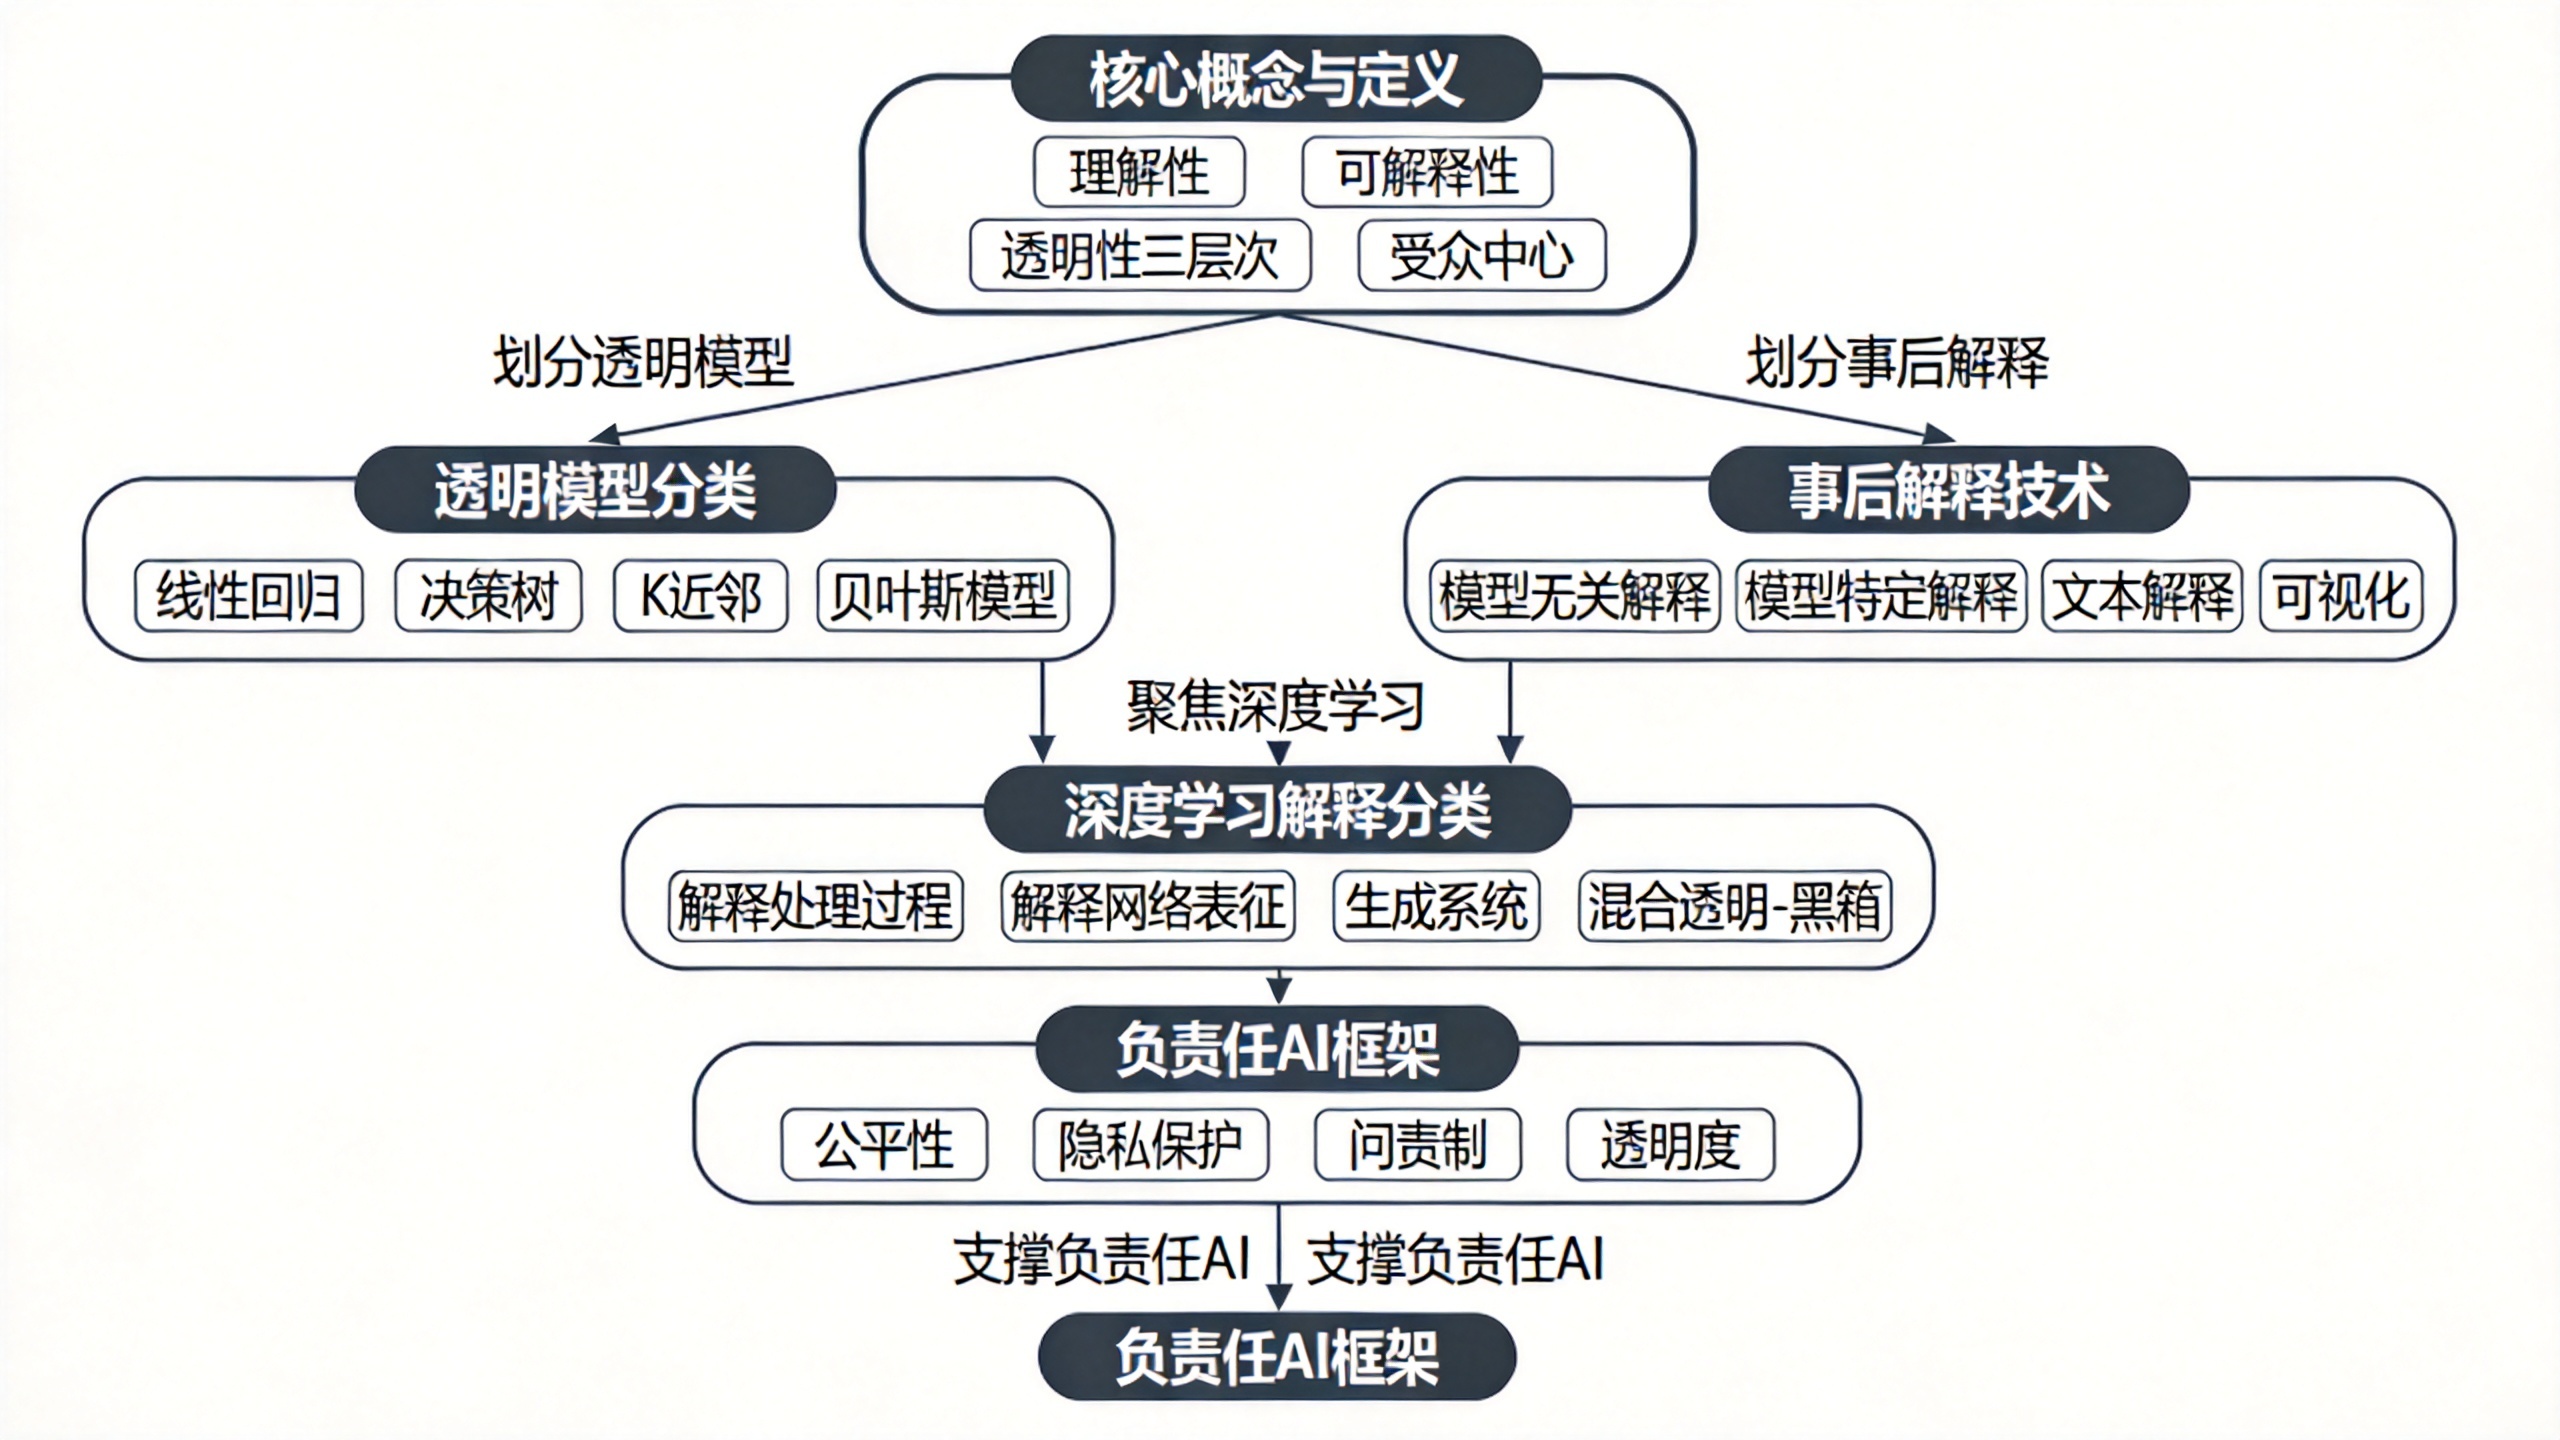
模块一:概念澄清与定义体系。 论文首先对理解性、可理解性、可解释性、解释性和透明性五个概念进行了精确区分,建立了概念层级。其中,理解性被视为最本质的概念,其他概念均与其关联。透明性被细分为三个层次:可模拟性(人类能完全模拟模型计算过程)、可分解性(模型的每个部分可被单独解释)和算法透明性(可通过数学分析理解模型)。这三个层次层层递进,且高层次包含低层次的特性。
模块二:透明模型与事后解释的分类体系。 论文将机器学习模型分为两大类。第一类是透明模型,包括线性回归、决策树、K近邻、基于规则的学习器、广义加性模型和贝叶斯模型。这些模型本身具有不同程度的可理解性,但其透明性取决于特征的设计、模型规模和目标受众的认知水平。第二类是事后解释技术,包括文本解释、可视化、局部解释、示例解释、简化解释和特征相关性解释六种。论文进一步将事后解释细分为模型无关技术(如LIME、SHAP)和模型特定技术(如针对CNN的反卷积网络、针对RNN的LRP扩展)。
模块三:深度学习解释的替代分类学。 针对深度学习模型,论文提出了一种从[13]引申的分类视角,将方法划分为四大类:解释深度网络处理(回答"为什么这个输入导致这个输出")、解释深度网络表征(回答"网络中包含了什么信息")、解释生成系统(专门设计来简化自身行为解释的模型)和混合透明-黑箱方法。这一分类体系与前述通用分类学互补,提供了更贴近深度学习特征的分类视角。
模块四:负责任AI框架。 论文将XAI置于一个更宏大的框架中,指出仅靠XAI不足以实现AI的负责任部署。负责任AI需要同时确保公平性、隐私保护、问责制和透明度,而XAI在其中起桥梁作用:为公平性分析提供技术支持,为隐私风险提供预警机制,为问责制提供审计基础。
文献分析与评估
这篇综述的文献覆盖范围具有显著优势。论文声称覆盖约400篇XAI及相关领域文献,文献检索截至2019年12月,发布时间与发表时间的接近性表明其对前沿动态的把握较为及时。从分类框架来看,论文的划分标准较为统一:以"透明性"为第一划分维度(透明模型 vs. 事后解释),以"受众"与"目的"为横向维度。这种多维度分类方法有效地反映了XAI领域的复杂生态。
论文对透明模型部分的处理值得关注。作者将线性/逻辑回归、决策树、KNN、基于规则的学习器、GAM和贝叶斯模型归为"透明模型"类别,并逐一评估它们在可模拟性、可分解性和算法透明性三个层次上的表现。值得注意的是,论文明确指出透明性并非模型的固有属性,而是随模型复杂度、特征设计、受众背景变化而变化的连续谱系。例如,一个决策树在小规模、特征可理解时是可模拟的,但一旦规则集规模增大,就会退化为仅具算法透明性的模型。这一观点有助于消解"白箱/黑箱"的二元对立,为选择解释策略提供了更细致的判断依据。
论文对事后解释技术的分析显示出清晰的演进路径。模型无关技术(如LIME、SHAP)代表了当前XAI的主流方向,其优势在于不依赖模型内部架构,可无缝应用于任何模型。论文特别指出,规则提取技术在模型无关方法中占据主导地位,这一趋势直观地反映了人类对"可理解知识"的偏好——将黑箱行为转化为可读的if-then规则,是对人类认知模式的直接对齐。相比之下,可视化技术在模型无关场景中应用有限,因为它通常需要模型内部状态信息而不仅仅是输入输出接口。
对深度学习模型解释的分析是论文的亮点所在。论文详细梳理了CNN的可视化方法演进:从Deconvnet(反卷积网络)到遮挡敏感性方法,再到类激活映射(CAM)和Grad-CAM,这一跟踪揭示了该领域的快速迭代。作者还注意到一个有趣的现象:大多数CNN解释方法实际上属于"局部解释",旨在回答"为什么这个特定输入导致了这个特定输出",而非提供模型的全局理解。这意味着,当前深度学习解释的"可解释性"本质上仍是一种局部性的、基于个案的"事后说明",而非模型自身的全局透明性。
从批判性角度来看,论文存在以下值得讨论的方面:
论文对"什么是好解释"的问题进行了哲学层面的讨论,引用了来自认知科学和社会科学的研究进展(如反事实解释的有效性、解释的选择性等),但并未将这些标准系统地整合到分类体系中。这意味着读者虽能了解各类方法的技术细节,但难以判断这些方法产生的"解释"是否符合认知科学的基本规律。这一点在论文自身也被识别为未来的挑战之一。
论文对数据融合场景下XAI的分析——特别是XAI可能危及数据隐私的讨论——具有前瞻性。作者提出了一种思想实验:如果一个黑箱模型通过XAI技术暴露了输入特征之间的相关性,而某些特征恰好是敏感或受保护的,那么XAI就可能成为隐私泄露的渠道。这一观点在2019年仍属前沿。但论文未提供具体的实验或案例支撑这一论断,这在一定程度上限制了其说服力。
此外,论文在分类体系中列出大量文献,但未对这些文献进行质量评估(如方法的实验验证情况、数据集使用的可靠性等)。这使得分类框架更像是"谁做了什么"的目录,而非"什么方法真正有效"的评价体系。尽管如此,鉴于综述的覆盖范围极大,这一做法在操作性上是合理的。
优势与局限性
优势方面: 这篇综述在系统性、前瞻性和概念精确性三个维度表现突出。论文首次将以受众为中心的视角正式纳入XAI的定义结构中,这一贡献具有范式意义——它将解释从"技术输出"升格为人机交互的"接口",为后续研究提供了理论基础。论文构建的双层分类体系覆盖了从传统机器学习到深度学习的完整模型谱系,为该领域的入门研究者提供了可靠的导航图。论文对负责任AI框架的讨论,特别是XAI与公平性、隐私保护的交叉分析,将技术问题嵌入社会责任与政策语境,显示了跨学科视野。
局限性方面: 论文未提供统一的XAI评估指标,这是作者自身也承认的重大缺口。论文虽然提出了XAI应具备的特征(如忠实性、可理解性、鲁棒性等),但未提出可操作化的量化方法,这意味着领域仍缺乏基准来比较不同方法的有效性。此外,论文对实验证据的依赖有限,大部分技术声称以概念性描述呈现,未进行系统的实验复现或性能比较。这些局限部分源于综述体裁本身,但对寻求实践指导的读者而言可能是不够的。
可复现性评估: 作为综述,论文未提供代码或开源实现,这是合理的。其价值在于概念框架而非可执行技术。但论文引用的方法中有不少已经开源(如LIME、SHAP、Grad-CAM等),读者可据此定位具体技术。
未来方向与开放问题
论文自身识别并讨论了多个尚未充分解决的问题,这些可以视为领域的前沿方向:
统一的XAI概念与评测指标。 论文强调,领域亟需就"可解释性"的核心概念达成共识,并基于此开发可量化的评价指标。这项工作需要社区协作,而非单一个体可以完成。一个可能的路径是借鉴社会科学中的设计——将这些指标设计为包含忠实性、可理解性、信息性等多个维度的复合指标。
解决深度学习可解释性的核心挑战。 论文指出,深度学习解释仍面临若干挑战:术语不统一(如saliency map、heatmap、attribution等混用)、评价主观性强、以及如何将概率性结果转化为包含因果链的定性概念。将连接主义与符号主义范式融合——即神经符号方法——被认为是解决这一问题的有效路径。
探索XAI与数据融合的交叉地带。 论文提出了一个值得深入探索的悖论:XAI既可增强模型理解,也可泄露敏感信息。在联邦学习、多视图学习、知识级融合等不同模式下,这一悖论的表现各不相同。如何在实现解释性的同时保障隐私,是一个亟需研究的问题。
XAI在公平性检测与去偏中的应用。 论文指出,XAI技术(如SHAP)可用于生成反事实解释,检测模型是否在受保护变量上存在歧视。但公平性与XAI的结合仍处于初期阶段,如何从"检测偏见到纠正偏见"仍需要系统的方法论探索。
从模型解释到知识构建。 论文展望了XAI与理论导向数据科学的融合——即利用XAI来验证模型习得的知识是否符合底层领域的理论约束。这一方向将XAI从"辅助理解工具"提升为"科学发现伙伴"。
组会预判问答
Q1: 论文提出的以受众为中心的定义是否真的具有操作性?受众的差异如何在实际中量化和落实?
论文指出,其定义的核心在于将"受众的认知能力与目标"纳入解释的设计中,但并未提出系统的方法论来指导如何针对不同受众定制解释。论文引用了一些初步的指导原则(如在解释中应保持选择性、应包含反事实信息、概率不如因果链重要等),但将这些原则落地为技术实现仍需大量后续工作。可以认为,这一定义在当前阶段更多是"为何需要关注受众"的概念性论据,而非"如何关注受众"的技术指南。
Q2: 论文将透明模型分为三个层次(可模拟性、可分解性、算法透明性),这一划分是否足够清晰?是否存在模型不符合任何层次的情况?
这三个层次确实形成了递进关系,且论文明确指出三者的包含关系(可模拟模型必然是可分解和算法透明的)。但论文自己也承认,透明度不是模型的固定属性而是随特征设计、模型规模和受众认知水平变化的连续谱系。这意味着,同一个模型在不同条件下可能落在不同层次。此外,论文的划分主要针对监督学习模型,对于强化学习、生成模型等其他范式,这一分类的适用性有待验证。
Q3: 论文是否过度强调了"复杂性-可解释性"之间的权衡?近年来的研究是否正在挑战这一假设?
论文承认"更复杂的模型不一定更加准确",但指出在数据足够丰富、分布足够宽广的情况下,复杂模型的灵活性确实可以带来性能增益,此时确实存在可解释性与性能的权衡。值得注意的是,论文引用了Rudin的工作指出,在某些高风险场景下,使用简单但透明的模型可能比事后解释复杂模型更可取。近年来的研究确实在"可解释性-性能"权衡问题上挑战了传统假设。一方面,通过知识蒸馏、模型简化等方式,可以在保持大部分性能的同时提升可解释性。另一方面,更好的解释技术(如注意力可视化、概念激活向量等)正在使黑箱模型的"黑度"降低。
Q4: 论文提出的负责任AI框架是否过于宽泛?它是否包含未被充分考虑的重要维度?
论文将负责任AI分解为公平性、透明性/解释性、隐私与安全、问责制等维度,这与欧盟委员会2019年发布的《可信AI伦理指南》高度一致。但一些研究者可能认为,负责任AI还应该包括更多维度,如环境可持续性、社会福祉(论文虽提及联合国可持续发展目标但未深入)、人类自主性与监督等。论文明确提出XAI是负责任AI的"核心概念"而非"唯一概念",这一定位是合理的。其局限性在于,论文对各个原则之间的关系描述较为松散,未能建立起系统化的互动模型。
本报告由立理AI生成,仅供参考,请以原文为准。
