OpenAssistant:众包构建大规模对话对齐数据集
论文信息
| 字段 | 内容 |
|---|---|
| 标题 | OpenAssistant Conversations - Democratizing Large Language Model Alignment |
| 作者 | Andreas Köpf, Yannic Kilcher 等 |
| 机构 | LAION 等社区组织 |
| 论文地址 | https://arxiv.org/abs/2304.07327 |
| 代码地址 | https://github.com/LAION-AI/Open-Assistant |
| 发表时间 | 2023年 (NeurIPS 2023, Track on Datasets and Benchmarks) |
一句话概要
针对大型语言模型对齐研究中高质量人类反馈数据稀缺且多属专有的问题,
论文通过召集超过13,500名志愿者,以众包方式构建了包含161,443条消息、
覆盖35种语言的多轮对话数据集OpenAssistant Conversations。
该数据集采用对话树结构并附有461,292个质量标注,以完全开放许可发布。
实验表明,基于该数据集微调的模型在多项基准上一致超越基线,
为LLM对齐研究的民主化提供了关键数据基础设施。
背景与研究动机
大型语言模型在近年取得了快速进展,其核心驱动因素可概括为:基于Transformer架构、增加参数量、扩大训练语料规模、提升训练计算量。然而,这些模型在普通公众中的采用率长期偏低。论文指出,这主要归因于模型预测与最终使用意图之间的失配,即对齐问题。
对齐是指确保AI系统不仅能成功优化提供的代理训练目标,还能使其预测符合预期目的并遵守人类提供的伦理与安全标准。论文提出,一种有效的对齐方案是助手风格的指令微调,即通过显式收集的人类偏好数据来使LLM生成更符合期望的输出。ChatGPT的成功正是这一路径的标志性案例,其核心技术是监督微调加基于人类反馈的强化学习。
论文引用Ouyang等人的工作,描述了RLHF的标准三步流程:首先收集人类演示的期望行为并训练SFT模型;其次基于人类对模型不同输出的排名训练奖励模型;最后使用PPO算法以奖励模型作为奖励函数微调SFT模型。这一流程的效果高度依赖于所使用数据的质量。
论文指出,当前公开可用的高质量人类反馈数据集极为稀缺。大多数可公开获取的对话数据集存在两类局限:一类由合成数据构成,即通过查询语言模型自动生成指令,其复杂性和创造力受限;另一类虽然使用人类生成的指令,但仍依赖语言模型生成回复。缺少广泛且高质量的数据,即使模型规模和预训练程度再高,也难以构建出有能力、有帮助、无害的AI助手。
研究在这一领域长期被少数具备大规模训练和数据收集资源的研究实验室垄断。这种对高质量数据的垄断妨碍了包容性和多样化的研究努力,尤其是对齐挑战这一被认为最重要的研究领域之一。论文的核心动机正是:通过开放和众包的方式构建并发布大规模对话数据集,以促进LLM对齐研究的民主化。
现有方法的瓶颈
论文所针对的具体瓶颈可以归纳为以下三点:
瓶颈一:高质量人类偏好数据稀缺且多属专有。 现有对齐技术如RLHF普遍依赖高质量的人类反馈数据,但这些数据收集成本高昂,且多为商业公司所持有,未向研究社区公开。这直接限制了开源社区在这一方向上的研究能力。
瓶颈二:现有开源数据集的质量和多样性受限。 论文分析了现有的几类数据集:如Self-Instruct等通过自动生成指令产生的数据集,依赖于预定义的指令类型列表,在复杂度、创造力和质量上存在不足;Vicuna等数据集虽使用人类生成的指令,但仍依赖语言模型生成回复。这些数据集的生成过程不够自然,难以覆盖真实用户多样化的使用场景。
瓶颈三:数据收集过程中缺乏系统化的质量控制机制。 即便是由人类生成的数据,如果缺乏统一的指导准则、垃圾过滤机制和一致的标注流程,数据质量也难以保证,进而影响下游对齐效果。
值得注意的是,这三点瓶颈之间存在内在关联:正是由于高质量的人类反馈数据收集成本高昂且难以规模化,才导致了开源社区数据的匮乏;而即使有人类参与,如果没有系统的质量控制,数据质量也无法保证。
核心洞察与贡献
论文的核心洞察是:通过精心设计的众包流程和激励体系,可以大规模、低成本地收集多语言、多样化的高质量人机对话数据,并以此推动LLM对齐研究的民主化。论文指出,超过13,500名志愿者在无财务激励的情况下完成了超过625,000个任务,生成的对话树涵盖从生物学到量子物理的广泛主题。这一事实本身就证明了众包路径的可行性。
基于这一洞察,论文的具体贡献包括:
-
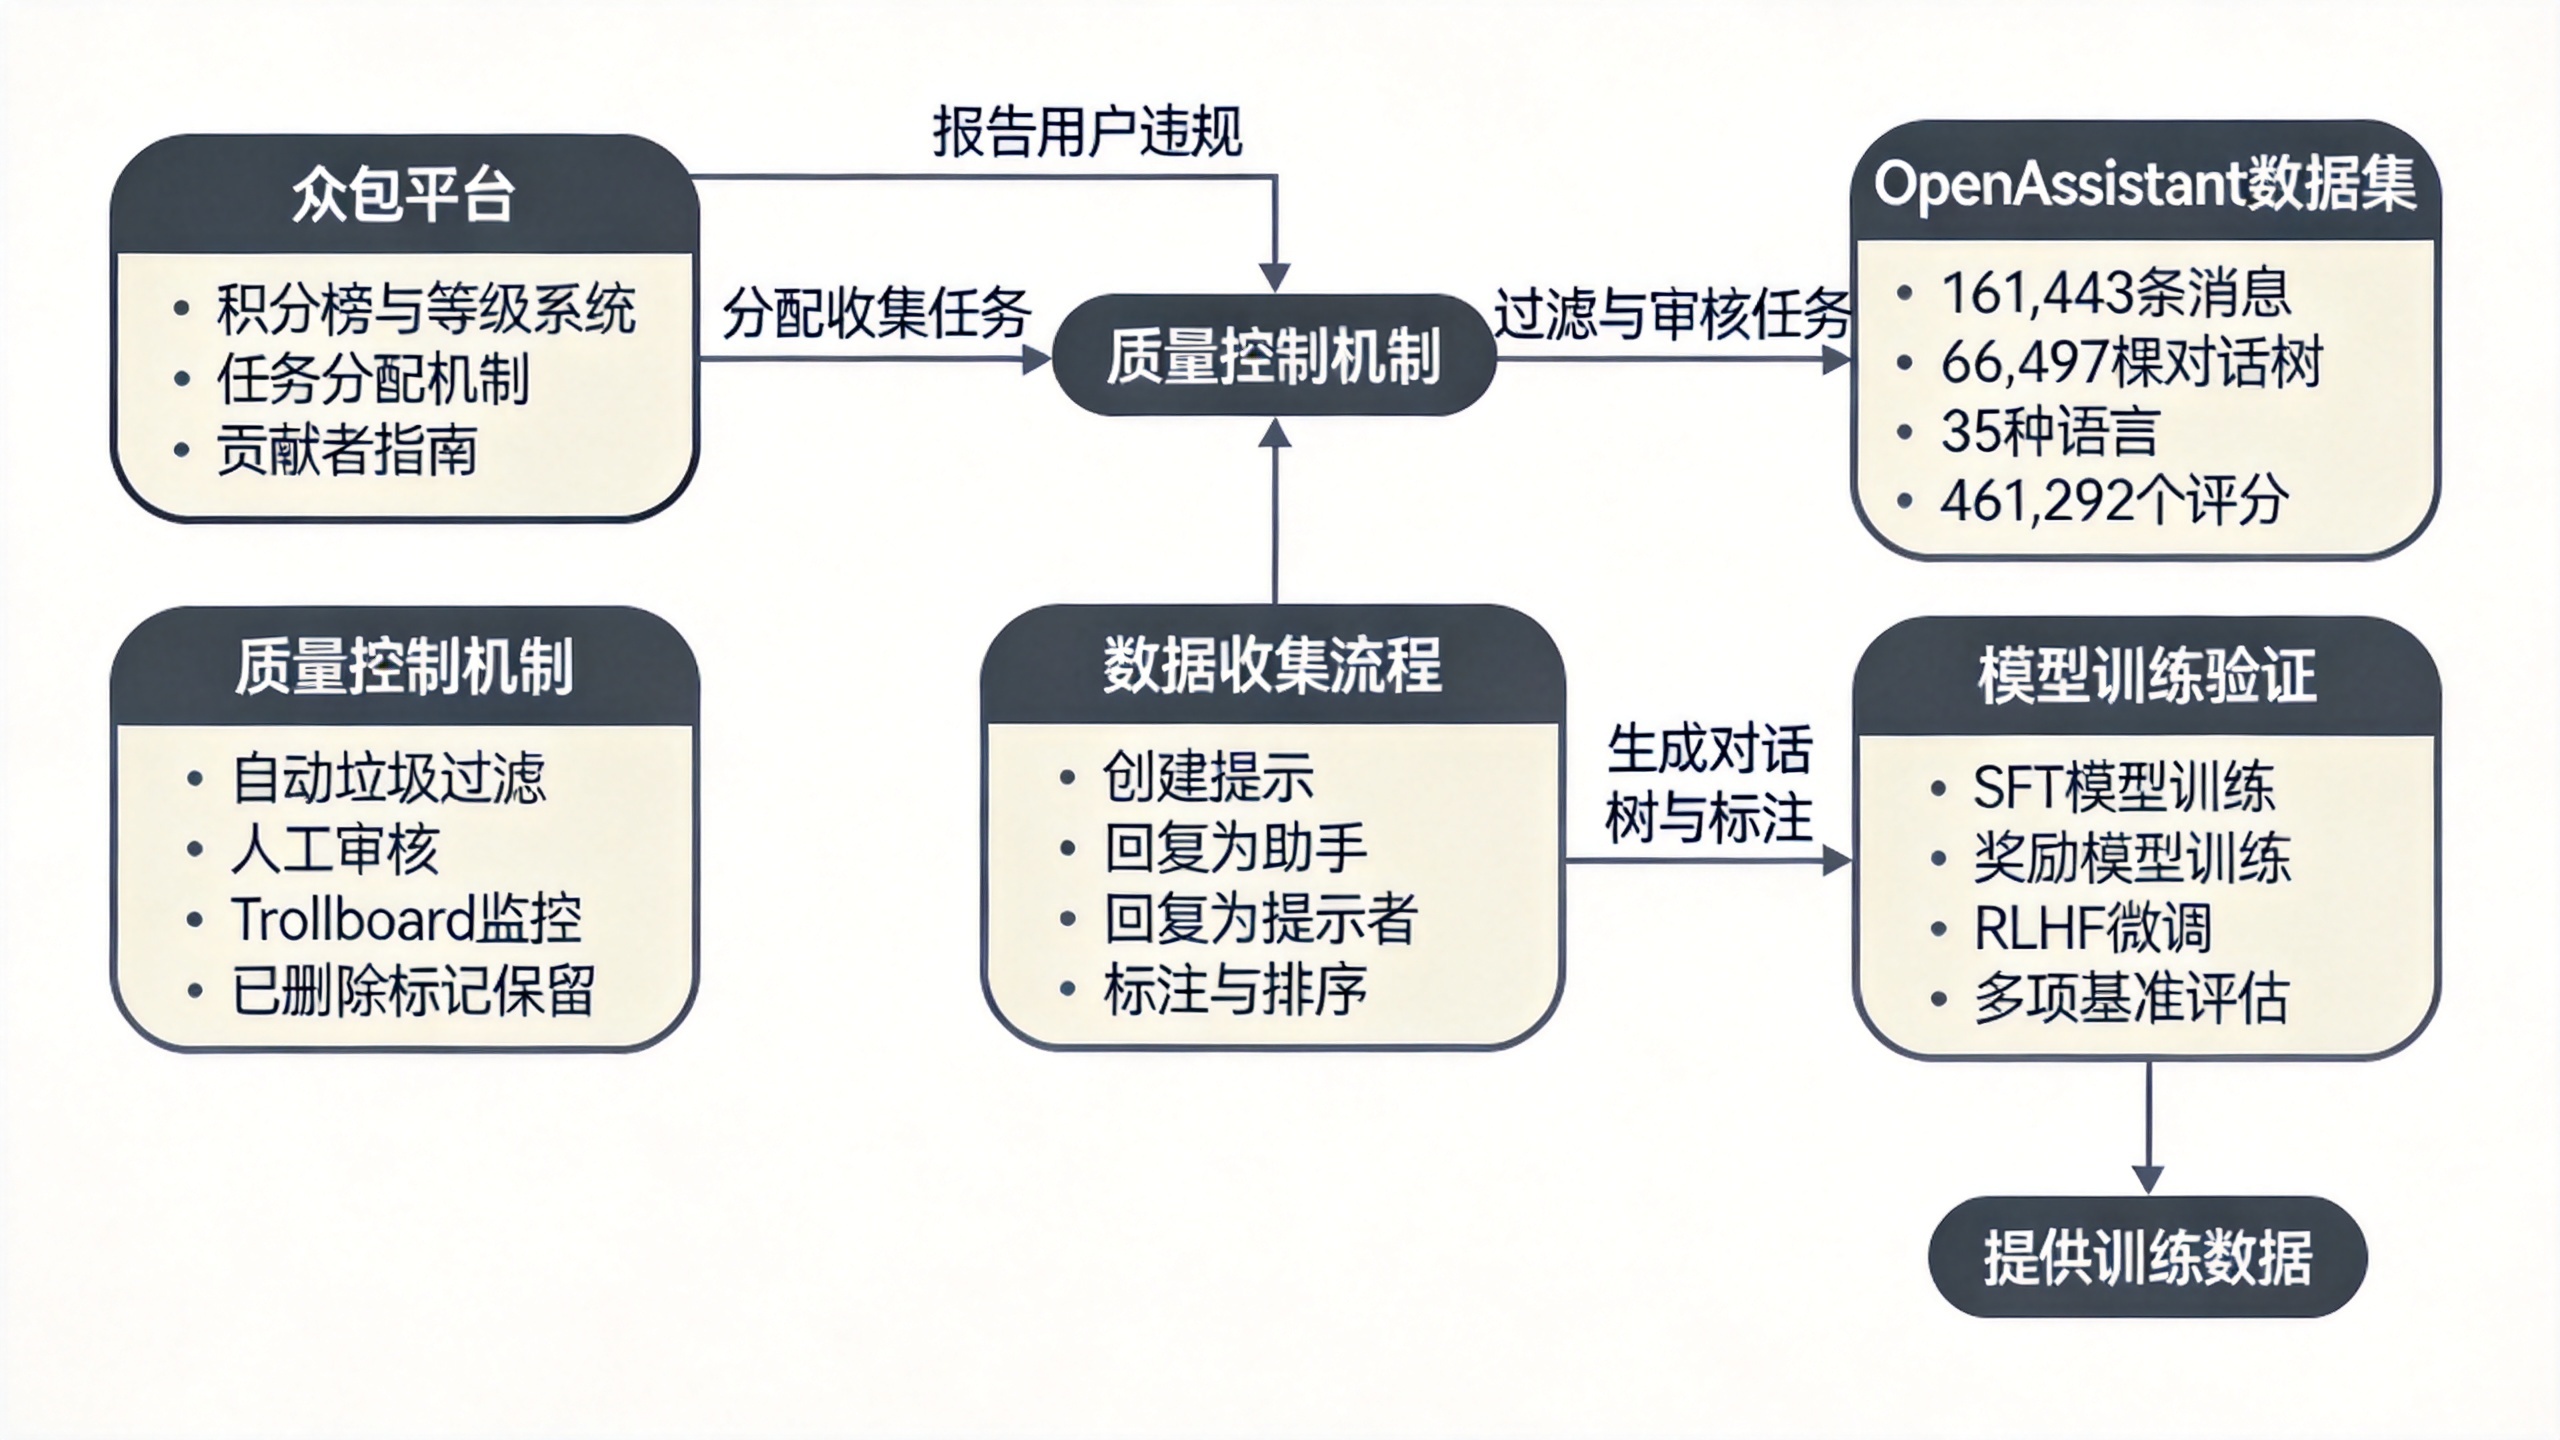
构建并发布了OpenAssistant Conversations数据集,包含161,443条消息、66,497棵对话树、覆盖35种语言,附有461,292个质量评分。这是目前公开可用的最大规模多语言人类对话数据集之一,且以完全开放许可发布。
-
设计了系统化的众包数据收集流程,将对话数据的构建拆解为五个独立步骤(创建提示、标注提示、回复、标注回复、排序回复),并引入对话树状态机管理数据从创建到完成的渐进过程,有效降低了因志愿者中途流失导致的数据损失。
-
建立了多层次的质量控制机制,包括积分榜与等级系统激励高质量贡献、自动垃圾过滤(auto mod)与人工审核结合、Trollboard对低质量用户的监控等,确保数据集整体质量。
-
基于数据集训练并发布了多个SFT、RM和RLHF模型,实验验证了数据有效性——基于OASST1微调的模型在多项标准基准上一致超越原始基线模型。
这些贡献分别回应了前述三个瓶颈:开放许可解决了数据专有问题;众包方式和对话树结构保证了数据的多样性和自然性;多层次质控机制确保了数据质量。
方法详解
数据结构
论文定义了对话树作为基本数据结构。树的根节点代表提示者给出的初始提示,每个节点标记角色(prompter或assistant),同一节点可以有多个相反角色的子节点,分别代表对话的不同走向。从根到任意节点的路径构成一个线程,代表一段有效的对话。每个assistant节点还配有基于用户偏好的排序信息。
论文选择对话树而非简单线性对话的原因在于:真实对话存在多种可能走向,树结构能够捕获同一提示下的多种回复路径,为奖励模型训练提供更丰富的偏好对。
单步收集流程
论文将数据收集拆解为五种任务类型,用户可自主选择或由系统按需求权重分配:
- 创建提示:用户写初始提示作为对话树根节点。为防止过量,系统采用抽签机制控制新提示进入后续流程的数量。
- 回复为助手:用户需仔细思考并可能进行外部调研以提供有帮助的回复。论文指出,尽管这一任务劳动强度最高,但因话题多样性而被用户评为最有趣的任务。
- 回复为提示者:强调多样性而非严格质量要求,示例如澄清问题、修改原始意图、提出追问或改变对话方向。
- 标注提示或回复:用户需从垃圾检测、指南遵循度、质量三个维度对消息进行标注。质量标注使用五点Likert量表,涵盖质量、创造性、幽默感、礼貌性和无害性。
- 排序助手回复:用户需对同一父消息的多个回复按偏好排序。
可以理解为,这种拆分设计的核心动机是降低单次任务的认知门槛和完成时间,从而降低志愿者流失率。同时,五种任务类型对应数据收集的不同需求阶段,确保每个步骤都能独立推进。
对话树状态机
论文设计了一个状态机来系统管理对话树的渐进式发展,主要状态包括:
- 初始提示审查状态:新创建的树进入此状态,由多个用户评估其质量。如果被标记为垃圾或不适宜,树进入aborted_low_grade状态并被移除;通过审查则进入growing状态。
- 生长状态:持续向用户发布任务(回复、标注、排序),推动树的生长。这一状态持续到树达到终止条件(如最大消息数或预定义标准)。
- 终止状态:树完成收集后进入此状态。
状态机的核心价值在于将不可控的众包过程转化为可控的管道流程。论文设定了多个平台参数(如最大活跃树数100、最大树深度5、每节点子节点数2等),研究者可根据研究目标进行调优。
贡献者指南
论文提出了详细的指南以确保持续性和质量,核心原则包括:助手回复应礼貌、有用、简洁、友好且具有安全意识;提示应探索多样化和具有挑战性的输入。值得注意的一点是,指南避免直接分类拒绝大部分请求类别,而是引入类似知情同意的理念——提供有用反馈而非断然拒绝,例如向请求者指出危险行为的风险、阐明AI助手的局限(如幻觉)。
质量控制
论文采用多管齐下的质保方法:积分系统依据任务难度分配权重,且大部分积分依赖于其他用户的交互反馈(如回复被标记为非垃圾且获得高排名则积累额外积分);标志系统(Trollboard)汇总用户收到的负面标签和举报,使版主能够主动审查潜在违规用户;保留已删除消息并标记为已删除而非直接移除,不导出用于训练。
实验与结果
论文通过训练SFT、RM和RLHF模型对数据集进行有效性验证,使用的基座模型包括Pythia、LLaMA和Falcon。
Table 1展示了基线与训练模型在多项基准上的评估分数:
| Model | LMEH | VEL | OAIE | HE |
|---|---|---|---|---|
| gpt-3.5-turbo (ChatGPT) | 1110 | 0.87 | 0.72 | |
| EleutherAI/pythia-12b | 60.33 | |||
| OpenAssistant/pythia-12b-sft-v8-7k-steps | 60.28 | 997 | 0.10 | 0.10 |
| tiiuae/falcon-40b | 72.29 | |||
| OpenAssistant/falcon-40b-sft-top1-560 | 74.04 | 1192 | 0.26 | 0.09 |
| OpenAssistant/falcon-40b-sft-mix-1226 | 74.40 | 1053 | 0.44 | 0.13 |
| huggyllama/llama-65b | 67.24 | |||
| OpenAssistant/oasst-sft-7e3-llama-30b | 68.03 | 979 | 0.52 | 0.20 |
| OpenAssistant/oasst-rlhf-3-llama-30b-5k-steps | 68.51 | 1068 | 0.51 | 0.15 |
实验结果显示:基于OASST1微调的模型在LMEH(覆盖BoolQ、PIQA、HellaSwag、WinoGrande、ARC-e、ARC-c、OBQA的NLU任务平均分)上一致超越对应基线,甚至在LLaMA-30B的情况下超越了更大的LLaMA-65B基线。RLHF模型在部分基准上优于SFT,但在另一些基准上并不占优。
论文还对falcon-40b的两种训练变体进行了对比:sft-top1仅使用排名最高的对话线程训练,sft-mix则混合OASST1与其他指令数据集。结果显示sft-mix在LMEH上略高但VEL、OAIE、HE上各有差异,说明混合不同数据源可以影响模型的能力倾向。
批判性评估:论文的实验设计在baseline选择上基本合理,覆盖了Pythia、LLaMA、Falcon三个常见系列并进行了同系列的横纵对比。但存在几个值得注意的问题:
- ChatGPT作为对比锚点的意义有限。论文在此处的对比更多是展示差距,gpt-3.5-turbo的LMEH评分1110与其他模型的60-74不在同一量级,这暗示评分标准可能不同或存在误标,但论文未对此解释。
- RLHF相对SFT的增益不显著。论文在局限性部分自行承认,其RLHF模型未达到InstructGPT论文中报告的那种统一且显著的改进。论文推测原因可能是奖励模型训练数据的不同——InstructGPT使用SFT模型生成消息的排名数据,而本文使用人类生成消息的排名数据。这一假设尚未验证,意味着OASST1在训练奖励模型方面的有效性存在局限。
- 缺乏针对数据质量的直接消融实验。论文未展示不同数据子集(如按语言或按任务类型划分)对下游性能的影响,也未给出合成数据的具体比例(仅提到8,576条合成消息)及其对整体效果的贡献。
论文还针对毒性检测进行了分析,采用Detoxify模型对保留消息和已删除消息进行自动化毒性评分。结果如下:
Table 2. Detoxify outputs across six categories of toxicity, comparing deleted and retained messages.
| Toxicity | Obscene | Threat | Insult | Identity Attack | Explicit | N | |
|---|---|---|---|---|---|---|---|
| Deleted | 4.625% | 1.965% | 0.411% | 2.085% | 0.651% | 1.39% | 3422 |
| Retained | 0.988% | 0.574% | 0.102% | 0.715% | 0.121% | 0.177% | 71359 |
结果显示:已删除消息在所有六个毒性类别上的平均评分均显著高于保留消息,验证了审核流程的有效性。但论文也诚实指出,已删除消息的平均毒性值仍然较小,意味着仅靠Detoxify等毒性检测模型不足以判断消息是否适合纳入数据集,删除消息的原因可能还包括缺乏事实准确性或语法质量差。
优势与局限性
优势
- 数据规模和多样性突出:161,443条消息、35种语言、461,292个质量评分、经过人工排序的回复对——在公开可用的对话数据集中,OASST1在规模和语言覆盖面上具有显著优势。
- 完全开放许可发布:相较于ChatGPT等专有系统的数据,OASST1以完全许可发布代码和数据,这对促进对齐研究民主化具有实际价值。
- 系统化的数据收集与质控流程:对话树状态机、积分激励、自动+人工审核相结合的质控机制,为后续众包数据收集项目提供了可复现的方法论参考。
局限性
- 人口统计偏差显著:论文的调查显示,89.1%的标注者认同为男性,中位年龄26岁。这种人口结构可能使数据集反映的价值观和兴趣范围存在偏差。论文承认,更活跃的用户贡献更多的标注,可能导致其价值观和兴趣在数据集中过度代表。
- 奖励模型数据收集方式与InstructGPT不同:论文使用人类生成消息的排名数据而非SFT模型生成消息的排名数据来训练奖励模型。这可能导致RLHF相对于SFT的提升不如InstructGPT显著,具体影响程度尚需进一步研究验证。
- 仍然存在不安全内容的可能性:尽管有多重审核机制,论文承认系统并非万无一失,数据集中可能仍包含不安全内容。已删除消息的平均毒性值偏低也从侧面说明单纯依赖毒性检测的局限性。
- 可复现性评估:论文代码和数据均已在GitHub和Hugging Face Hub上以开放许可发布,训练配置在附录中详细说明,实验设置细节充分。但论文未提供完整的训练日志或模型检查点的谱系(如PPO训练中涉及的多步模型),可能会影响对某些实验结果的精确复现。
未来方向与开放问题
- 基于SFT模型生成的排名数据收集:论文明确指出,计划未来收集基于自身SFT模型生成的回复排名数据,以验证其对RLHF性能提升的影响。这是一个直接的后续方向。
- 不均匀贡献者分布的效果研究:论文指出,需要进一步研究当给定清晰、通用任务时,不均匀的贡献者分布对数据整体质量的影响程度。
- 更精确的数据收集标准:论文认为,需要进一步研究以确定对RLHF更有用的数据收集标准。这可能包括对不同任务类型、提示多样性水平与最终对齐效果之间关系的系统性分析。
- 政治倾向评估的方法论完善:论文初步评估显示OASST1训练的模型在政治倾向上比ChatGPT更加平衡和多样化,但论文承认评估方法尚未达成社区共识。改进评估方法论并开展更大范围的偏差分析是未来值得跟进的方向。
组会预判问答
Q1: OASST1数据集的规模与现有数据集相比如何?
A: 论文展示了OASST1与现有数据集的对比。OASST1包含161,443条消息、66,497棵对话树、35种语言、461,292条质量评分。相较于Self-Instruct、Alpaca等主要依赖语言模型生成的合成数据集,OASST1的优点在于所有消息均由人类生成或排序。与Vicuna相比,Vicuna使用人类指令但依赖语言模型生成回复,OASST1的回复同样来自人类。论文强调,OASST1在语言多样性和对话结构的自然性方面具有优势。
Q2: RLHF模型相对于SFT模型的改进不明显,这是否意味着OASST1不适合RLHF训练?
A: 论文在局限性部分明确讨论了这一点,并指出可能的原因:InstructGPT使用其初始SFT模型生成的消息进行奖励模型训练,而OASST1使用人类生成消息的排名数据。论文认为这至少可以部分解释性能差距。值得注意的是,论文并未排除其他可能原因,如数据规模、基座模型差异或PPO训练的超参数设置。论文计划在后续工作中收集基于自身SFT模型的排名数据以验证这一假设。可以理解为,这一局限是方法论选择的结果,而非数据本身的固有缺陷。
Q3: 数据集的人口统计偏差是否严重影响其实用性?
A: 论文指出89.1%的标注者认同为男性,中位年龄26岁,且少数活跃用户贡献了大部分数据。论文认为这种人口结构可能使数据集反映的价值观和兴趣范围存在偏差。论文建议未来可采用更受约束的对话生成方式(如从随机维基页面采样话题)来缓解这一问题。但论文也报告了用户满意度调查中超过95%参与者"同意"或"强烈同意"自己很高兴参与该项目,且40%参与者是第一次贡献开源项目,这显示了社区参与的积极性。一种可能的解读是,尽管存在偏差,OASST1仍比完全由单一文化背景下的小团队生成的数据更具多样性。
Q4: 论文如何确保收集到的回复不是来自ChatGPT等AI模型?
A: 论文在附录D中详细说明了过滤机制:指南明确禁止贡献者从其他AI模型复制粘贴回复;被发现发布ChatGPT生成回复的用户被禁止贡献,其数据被删除;使用多重自动检测手段(如搜索"as a large language model"或"knowledge cutoff after September 2021"等特征字符串);用户之间的点赞与点踩机制进一步帮助筛查低质量或可能是AI生成的回复。论文承认这些机制无法消除所有ChatGPT生成内容,可能需要更多的事后过滤。
本报告由立理AI生成,仅供参考,请以原文为准。
